Bernini – 字节跳动开源一体化视频生成编辑框架
Bernini为字节跳动开源一体化视频生成编辑框架,采用MLLM语义规划+DiT视觉渲染两段解耦架构:多模态大模型解析指令、输出语义布局,Diffusion Transformer负责高清画面渲染;原生打通文生视频、图生视频、精细化视频编辑、多素材融合等能力,项目推理源码与模型权重全部开源。
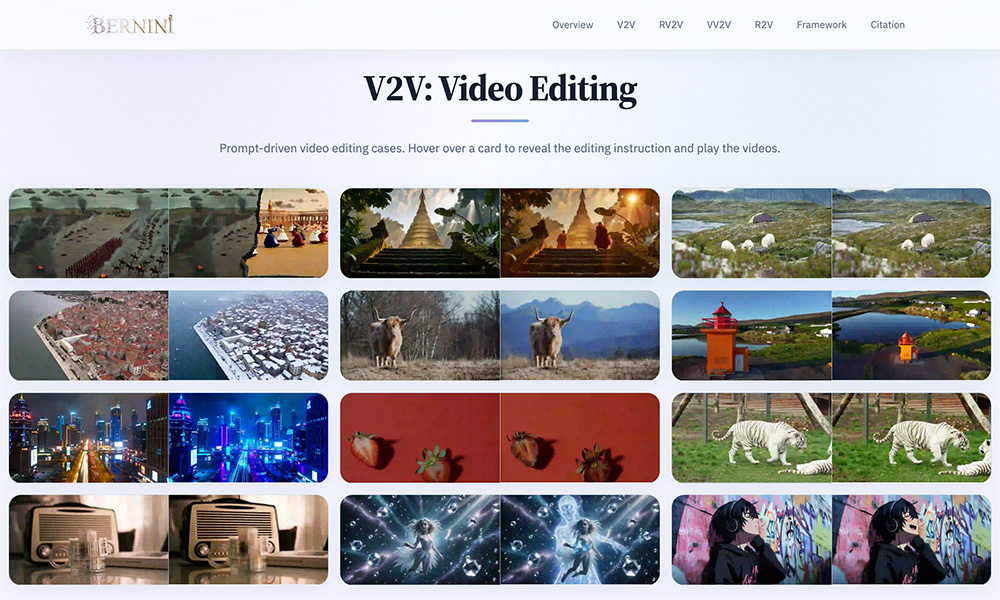
Bernini核心功能:
1、图文生视频:
依托文本描述、单图/多素材拼接图/多视角参考图,一键生成成片。
2、精细化视频编辑:
按需修改场景环境、拍摄视角、画面焦点、角色动作四大维度内容。
3、多参考定向引导:
凭借主体、材质、风格三类参考图,精准把物体形态、纹理、画风落地至目标视频。
4、画面素材植入:
海报、短片素材可嵌入画面屏幕、广告牌等区域,跟随镜头同步变换透视,时序无畸变。
5、多元素融合创作:
多张独立参考图拼接生成同一角色,依托场景关键帧自动生成连贯运镜画面。
Bernini核心优势:
1、语义与生成分层:
大模型理解需求、DiT落地画面,改善传统生成模型指令理解偏差问题;
2、任务大一统:
单套架构统一实现生成、剪辑、参考图驱动等全场景,不用更换模型;
3、多素材兼容:
文本、图片、视频混合输入,SA-3D RoPE规避多源素材时空错乱;
4、局部编辑可控:
编辑复用原视频特征,仅修改目标区域,不破坏原有画面细节;
5、全开源落地:
代码、权重完整开源,降低学术研究与商用二次开发成本;
6、泛化性能优异:
对训练集未覆盖的动作调整、因果类创意指令同样具备优秀生成效果。
Bernini部署使用步骤:
1、GitHub拉取项目源码至本地;
2、执行pip安装项目依赖清单;
3、从HuggingFace获取Bernini-R-Diffusers权重文件;
4、运行环境:Python3.11.2、CUDA12.4及以上,优选Hopper架构显卡;
5、torchrun启动多卡推理,载入配置与测试样本;
6、选配兼容OpenAI协议的API接口,优化提示词生成效果。
 vue-skills
 Kaggle 机器学习课
 Loopit
 ShowMeAI
 Outset.ai
 语构
 驭码 CodeRider
 Avanty
 Takomo
 Bernini